一个人做完一集短剧:我把 AI 产线拆成 6 道工序
- 2026-10-08 09:12:55
QUOTE
你不是缺一个更强的模型,你是缺一条能重复跑通的产线。
我在后台收到最多的一类留言是这样的:
READER
我装了 ComfyUI,也买了显卡,提示词看了几十篇,为什么一集三分钟的片子还是做不出来?
这个问题问得很好,但它问错了方向。
装着几十个 AI 工具的电脑,和能从零到一交出一集成品的产线,中间隔着的不是模型版本,也不是提示词水平,而是一件事:你有没有把这件事拆成工序。
我最近一个人做了一部三集的竖屏短剧,一共 207 个镜头,正片 8 分 50 秒,全部在自己的一台 8GB 显存的机器上跑完。做到第三集的时候我复盘了一遍,发现真正让我从「做不出来」变成「做得完」的,不是换了什么模型,而是我把整件事拆成了 6 道工序,每一道工序只干一件事,干完就能检查。
这篇文章就把这 6 道工序完整摊开。你不需要有显卡,也不需要会写代码,你需要的是看完之后,把手上正在拖的那件活儿,也照着拆一遍。
本文看点
01
六道工序全摊开
02
颗粒度决定返工半径
03
提前避开三个坑
01
CONCLUSION
先说结论:会工具不等于出成品
新手最容易掉进的坑,是把工具当能力。
手里攒了四五个出图工具、三四个视频模型、六七个配音方案,每看到一个「又出新的了」,就赶紧去试。三个月过去,硬盘里躺着一堆精美的单张图和零散的几秒视频,但没有任何一条完整的内容。
我管这个叫素材坟场。它的本质是:你在用工具的丰富度,替代工序的完整性。
出一张好看的图,和做完一集片子,是两种完全不同的能力。前者是单点能力,后者是组织能力。单点能力可以靠试错积累,组织能力只能靠拆解获得。
判断标准很粗暴:如果你现在关掉所有新工具,只用你手上已有的,你能不能在三天内交付一条完整成品?如果能,你已经有产线了;如果不能,你手上的不是产线,是一堆零件。
那产线长什么样?往下看。
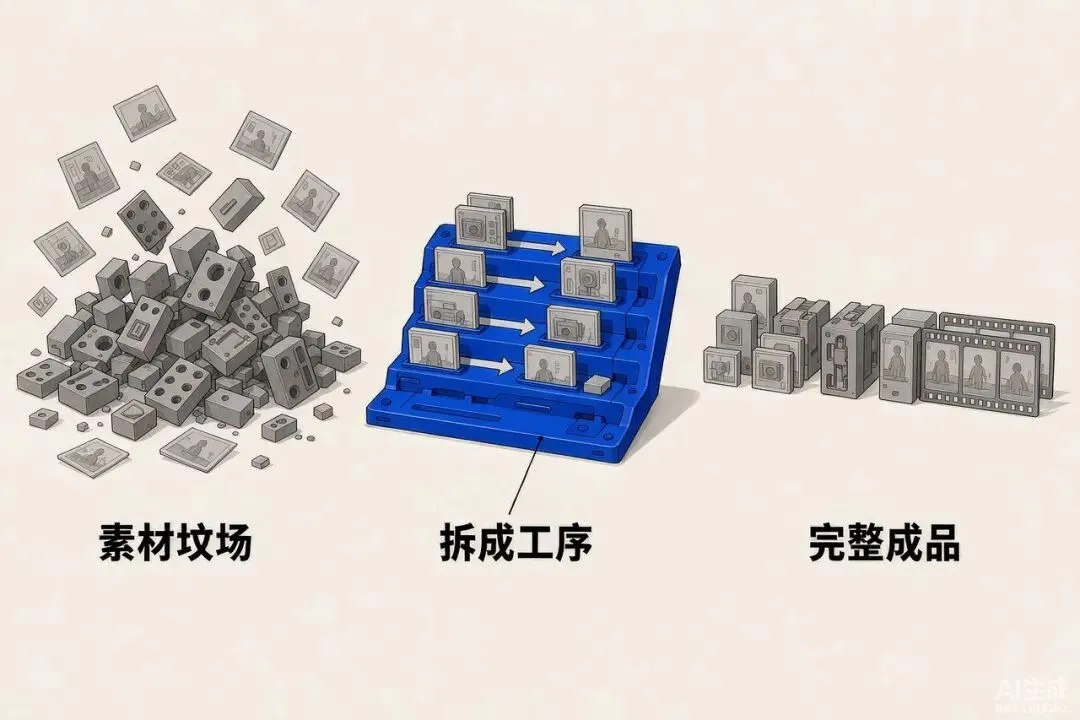
— 左边是工具堆出来的素材,右边是工序排出来的成品
02
SETUP
开工之前,先把这三件事定死
很多人一上来就开始写提示词,这是把顺序做反了。开工前有三件事必须先钉死,钉不死,后面每一步都要返工。
竖屏还是横屏,分辨率多少,单条多长,总共几条。我这部片子的规格是:竖版 9:16,视频 480×832,单条约 5.17 秒,三集共 207 条。规格定死之后,后面所有参数都不用再想,直接照着匹配。
这个数字决定了你后面拆镜头拆多细。我给自己定的是两条硬线:单镜时长不超过 5 秒,单镜台词不超过 3 秒。为什么是这两条?因为视频模型对时长越长的镜头,一致性越容易崩;而台词超过 3 秒,嘴型和音画同步就基本靠运气。
也就是「改一个地方要重做多少」。这条最容易被忽略,但它直接决定了你能不能做完。如果你把 207 个镜头当成一个整体来改,那每次修改都是灾难;如果你让每个镜头独立成文件、独立可替换,那改一个就只改一个。
这三件事听起来很笨,但它们能省掉你后面 80% 的无效劳动。
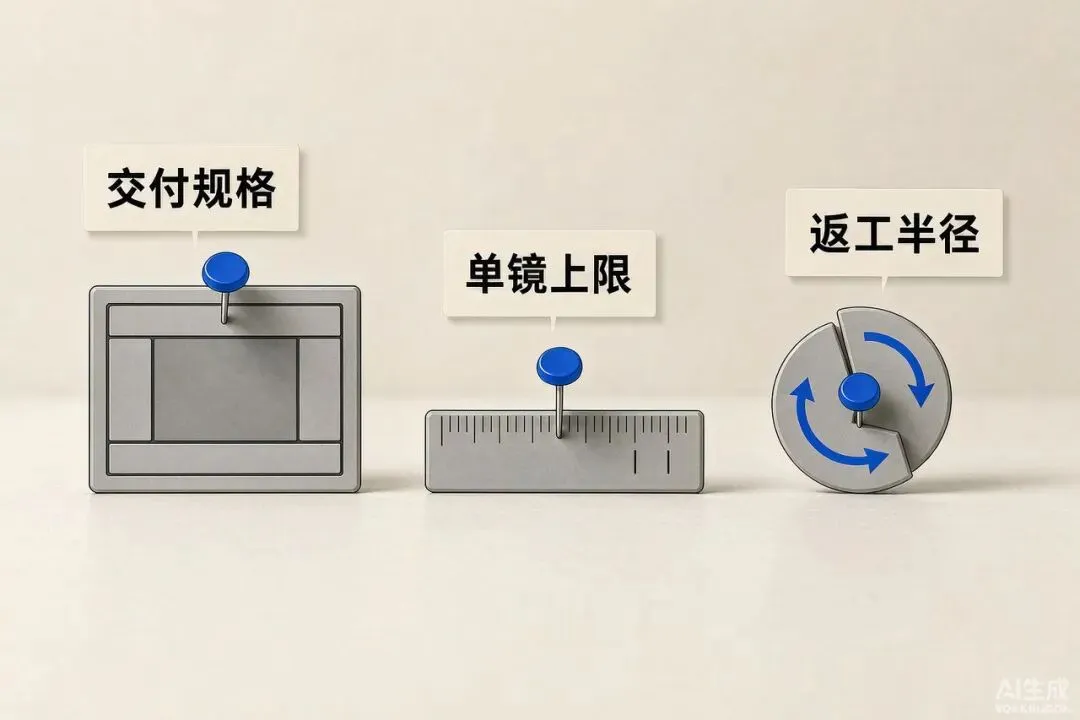
— 规格、上限、返工半径,开工前就得钉死
03
SIX STEPS
六道工序:一道都不能省
好,现在讲核心。整部片子我拆成了 6 道工序,顺序不能乱,每一道都有明确的输入和输出。
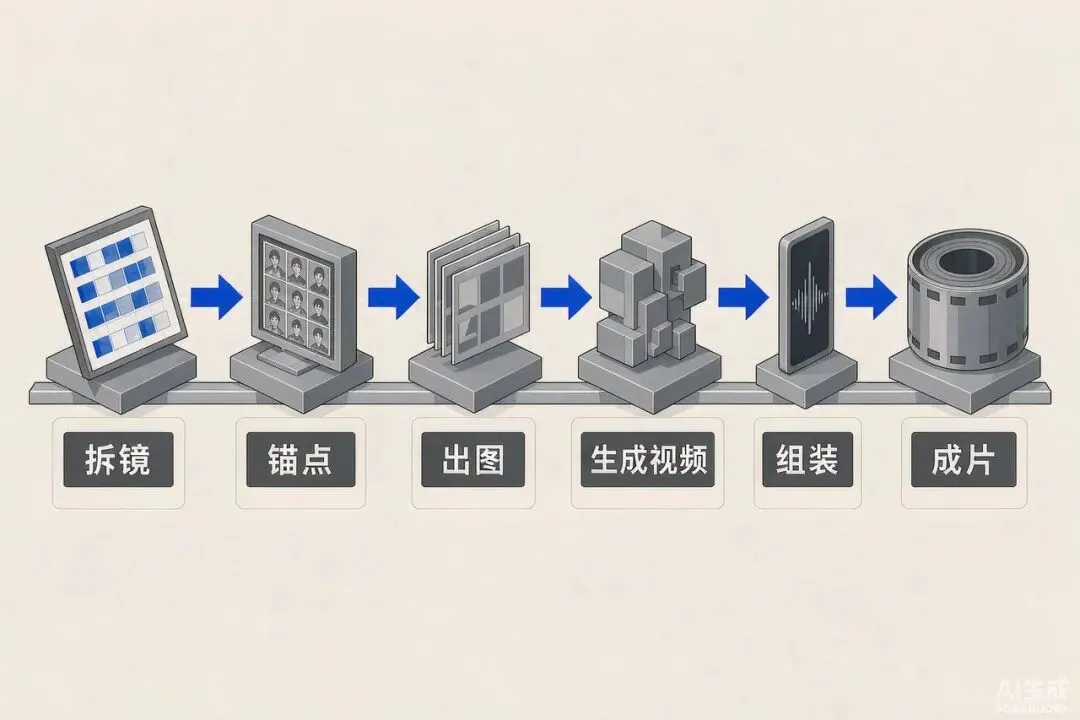
— 六道工序串成一条线,每道只干一件事
输入是一段故事文本,输出是一张分镜表。这一步唯一的目标是把时间切成镜头,注意不是「把画面写好」,是「切时间」。我的经验是:先把每一句台词、每一个音效都标出来,然后台词和音效各占一个独立镜头。为什么?因为音效和台词如果挤在一个镜头里,后面配音和画面对齐时会互相拉扯,改一个毁一个。
输入是分镜表,输出是一份角色锚点清单。这一步要干的事,是把主要角色的外形描述、服装、配色、画面里的位置,写成一段固定不变的文字。之后不管画哪个镜头,这段文字原封不动贴进提示词。新手最大的误解是以为「提示词写得越长越好」,其实不是,是同一段描述在每一个镜头里长得一模一样,角色才不会换脸。
输入是分镜表加锚点清单,输出是每一镜的静态图。这一步的关键词是「批量」,不是「精修」。我的做法是先按分镜顺序全部跑一遍,把明显不行的挑出来重跑,而不是一镜一镜磨到完美再往下走。因为你会发现,很多时候某张图你觉得不够好,放到视频里根本看不出来;而有些你觉得完美的图,一动起来就废了。先跑通,再优化。
输入是静态图,输出是短视频片段。这里的核心是一动一静:让镜头动,但让角色尽量别动幅度太大。原因很现实,图生视频对角色大幅度运动、转身、快速位移的处理,目前还远远达不到能用的水准。所以我在拆分镜的时候,会有意识地规避「角色从画面左侧走到右侧」这种镜头,改成「角色停住说话,镜头微微推近」。
输入是视频片段和音频,输出是对齐后的成片段。这条工序最枯燥,但也最省不得。因为前面拆镜拆得细,这一步反而变成了机械活:每一条视频配一条音或一条台词,时长不匹配就删帧或补帧,不用动脑子。
输入是所有成片段,输出是完整一集。这一步要检查三件事:镜头顺序有没有错、音画有没有错位、总时长跟目标差多少。我这部片子最终落在 8 分 50 秒,和一开始的规划误差在 20 秒以内,靠的就是这一步逐段核对。
04
GRANULARITY
拆镜头的颗粒度,决定了返工半径
这 6 道工序里,最容易被低估的是工序一,也就是拆镜。
新手拆镜最容易犯的错是拆得太粗。一个镜头里塞进两句话、三个动作、一次转场,看着「信息密度高」,实际上是给自己埋了三颗雷:时长超了没法压、一致性崩了没法救、改一句台词要重做整段。
我第一版的做法就是粗拆,结果做到第三个镜头就发现:单镜时长普遍超过 8 秒,模型给的结果开始明显劣化。后来我推翻重做了一遍,把镜头数从原计划的 190 个加到了 207 个,看起来工作量变大了,但实际交付速度反而快了一倍多。
原因很简单:细颗粒度不是增加工作,是把不确定性切成小块。
一个 8 秒的镜头,如果第 6 秒崩了,你要重跑整个 8 秒;一个 5 秒的镜头,如果第 3 秒崩了,你只需要重跑这 5 秒。返工半径从 8 秒降到 5 秒,看着只降了 3 秒,但乘上 207 个镜头,就是完全不同的工作量。
190
原计划镜头数
207
实际交付镜头数
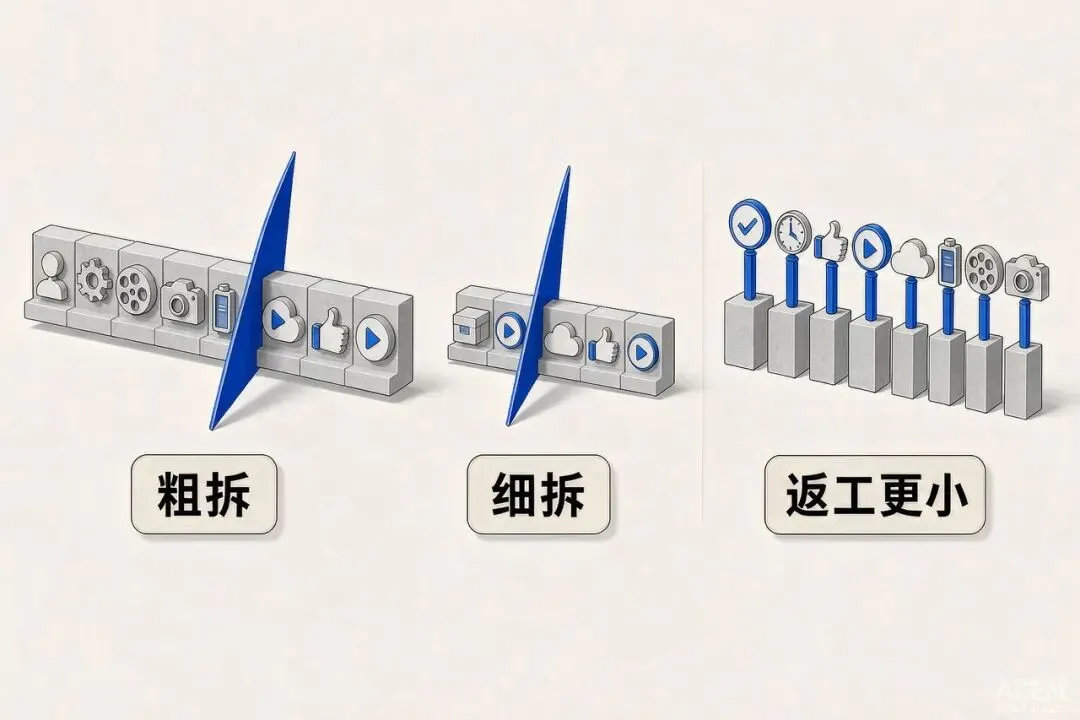
— 拆得越细,单次返工的范围越小
05
PITFALLS
我踩过的三个坑,你可以少交一次学费
三个坑按我踩的顺序排,中招概率依次递减。
我一度同时在用四个出图方案,理由是「哪个出得好用哪个」。真实结果是每次出图我都要重新回忆每个工具的脾气,出图效率反而下降。后来我砍到只用一个方案,出图速度立刻上来了。一道工序只留一个工具,这是新手最该先做的减法。
有段时间我执着于「这张图差一点,我再补两句提示词就完美了」。实际上当一张图的方向就不对时,补提示词只是拖延。正确做法是直接重跑,因为重跑的成本远低于反复修补的时间成本。
我一开始的想法是「先随便生成,最后统一剪辑处理」。结果是所有镜头的时间基准都不一样,对齐的时候几乎崩溃。音画一体、拆镜时就定死时长上限,比事后补救省力十倍。
NOTE
这三个坑有一个共同点:它们都不是技术问题,是工序顺序问题。
06
RESULT
效果对照:同一部片子,两次生产的差别
最后说结果。同一部片子,我按两套方式各做了一遍。
改动前:粗拆镜头 + 多工具并行 + 事后对齐。做出一集(大约 60 个镜头)花掉的精力,大概等于我全部的业余时间,而且中间放弃了两次。
改动后:6 道工序 + 单工序单工具 + 拆镜时定死上限。三集 207 个镜头全部跑完,中间只因为规格调整重做过一次,其余都是按工序顺序推进。
区别在哪?不在模型,不在显卡,在我有没有把「做一部片子」这件事,拆成六件可以分别完成、分别检查的小事。
如果你现在手上刚好有一件拖着没做完的活儿,我的建议是:先别急着找更好的工具,把它拆成工序。
— 同一部片子,两种做法得到两种结果
∞
THE END
工具会过时,工序不会
「真正的效率提升,从来不是换一个更聪明的工具,而是把一件事拆到你今天就能动手的那一步。」
本文配图由 AI 生成,仅作结构示意。

