一句话出一条短剧:1.6 万星的开源桌面 App,把整条制作线塞进一台电脑
- 2026-10-20 20:17:49
摘要:GitHub 上的开源项目火宝短剧(Huobao Drama)由 chatfire-AI 维护,目标只有一个:让短剧制作全自动。大模型负责拆剧本、盘角色、理分镜,图像与视频模型负责把每个镜头画出来、动起来,最后由 FFmpeg 合成整集。桌面版把服务端、数据库、FFmpeg 一样不落地打进安装包,装完只差一个 API Key。
项目介绍:它到底是个啥
官方主页上那句 slogan 很短:一句话生成完整短剧,剧本到成片全自动。项目出自 chatfire-AI,但和同门 Toonflow 的那套「工作台」玩法不是一个路数——火宝押的是开箱即用:服务端直接塞进桌面 App,普通人下载、安装、填上 API Key,整条流程就通了。 它不逼你先学工作流编排,而是替你把从解析剧本、生成角色场景、切分分镜到合成成片的整条链自动焊好。模型默认接官方家的火宝 API,设置面板里点一下就能写入三套推荐配置;想自部署也欢迎。它的定位可以压成一句: 开箱即用的一站式短剧生产线:剧本进,成片出。
功能特性:从一句话到成片,靠的是这几板斧
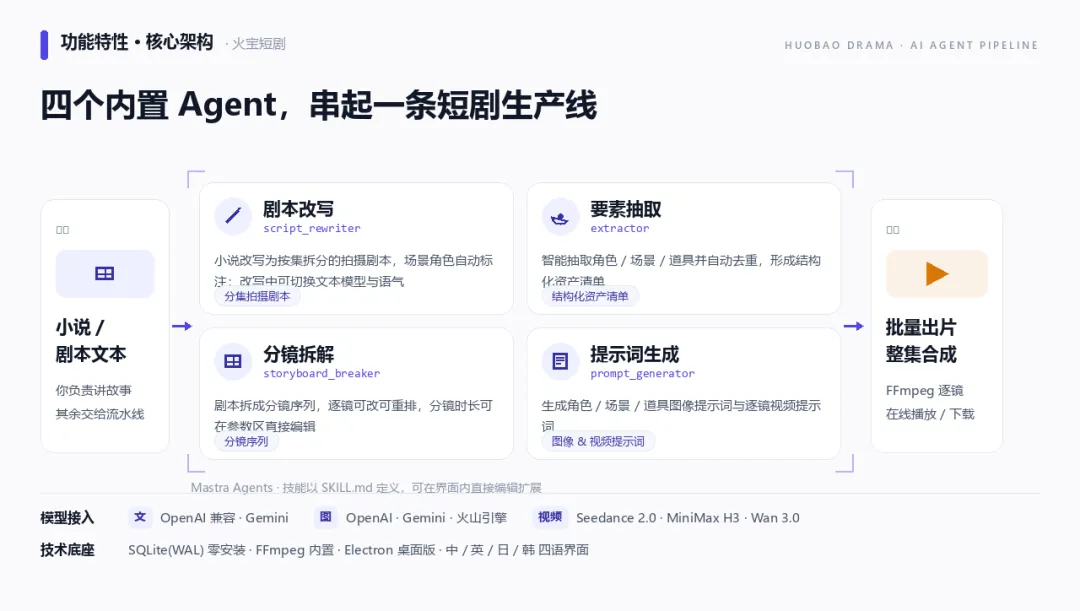
火宝的思路很直接——小说喂进去、成片交出来,中间改写、抽取、拆分镜、写提示词、拼视频这些活儿,全由四个内置 Agent 和一条工作台流水线代劳。
核心能力一览
四 Agent 接力:改写、抽取、分镜、提示词四棒自动交递,中途不停摆 一致性引擎:@角色 自动挂上参考图,拍到第几集人物长相都不漂移 模型矩阵:顶栏即点即换——Wan 3.0、Seedance 2.0、MiniMax H3 随便挑,同一份分镜能横向跑出多个档位 批量生产线:出片前先弹确认单,镜头数与总时长摆在一起核对;废片支持整批一键重跑 本地工程底座:FFmpeg 和数据库都随包带上,不碰命令行,双击图标开工
下面一块一块拆开看。
第一棒到第四棒:小说怎么变成片
script_rewriter(剧本改写):把小说原文直接翻拍成按集划分的拍摄本,场景、角色自动做好标记;改写中途文本模型可换、语气可调extractor(要素抽取):负责盘家底——剧本里的角色、场景、道具逐个抽出、自动合并重复项,最终落成一份结构化资产清单storyboard_breaker(分镜拆解):把本子切成一格格分镜,每一格都能改写、能拖动重排;镜头时长在旁边参数区里点数即改prompt_generator(提示词生成):出提示词——角色、场景、道具各配一份图像提示词,分镜则逐个配上视频提示词
一致性引擎:连拍多集,人物不崩脸
先给所有角色、场景、道具批量做一套一致性参考图,之后生成视频时它们会自动被当作参考素材带上 写分镜时只要 @某个角色,系统就会自动把 TA 的参考图递过去,省掉手动传图对位的功夫 素材库统一收在本地,任务跑到哪一步随时可查;列表页自己会生成 400px 缩略图和封面帧,翻起来不吃带宽
模型矩阵:顶栏一排按钮,换模型像换挡
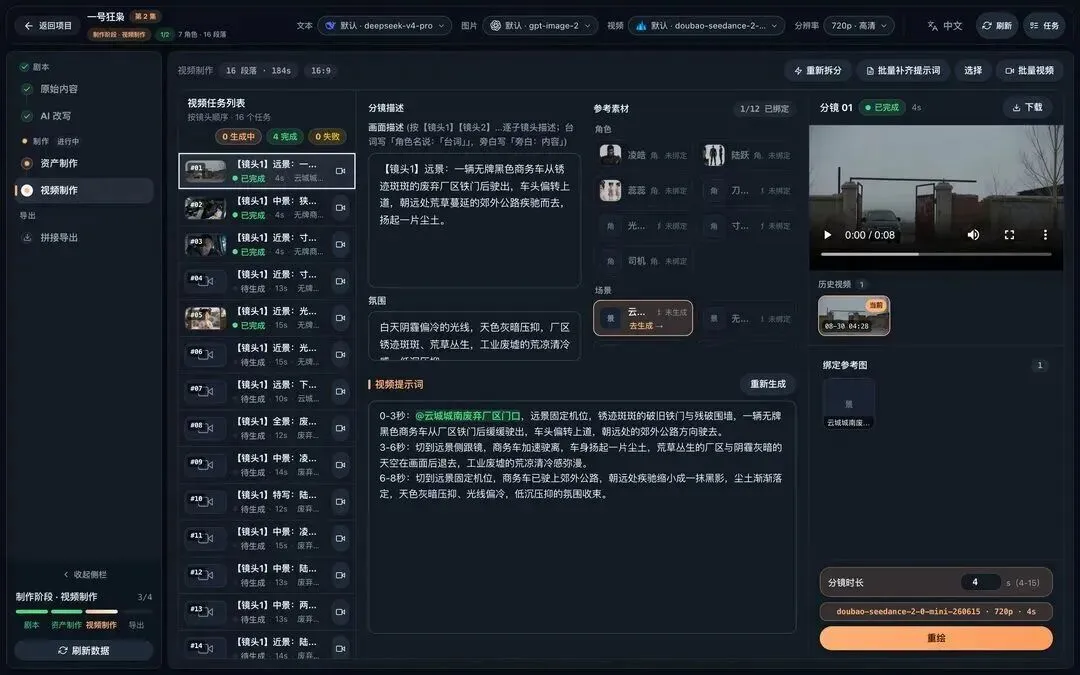
想换模型,顶栏点一下就行;分辨率档位与各家原生规格一致:Seedance 480p/720p、MiniMax 768P/2K、Wan 480P/720P/1080P 上手最省事的路径是贴一个 Huobao API Key,文本、图像、视频三组推荐配置一次写齐;想逐家手动接也行,模板自带连通性测试;图生视频与文生视频两条路都开着
批量生产线:先确认再开跑,废片整批重来
整集批量生成前会先弹一张确认单,镜头数、总时长、模型与分辨率列得清清楚楚,你点头它才动工 跑挂的任务一键补跑;如果卡在内容审核上(真人或敏感画面),提示语会直接劝你换个模型再来,而不是丢一句错误码了事 镜头时长就写在视频参数区里,单独重做一个镜头和整批跑,改法完全一样
本地工程底座:不用命令行,双击就开工
数据库用的是开启 WAL 的 SQLite,单文件、免安装,首次启动自动把表建齐;以前用 MySQL 的老部署也有迁移通道(每张表对完行数、写入前自动备份) FFmpeg 与 FFprobe 直接打进安装包:单镜合成、字幕压制、整集拼导,全都自己动手,不劳烦系统环境 桌面版基于 Electron(macOS / Windows 两平台),装完即用:端口自动分配、单实例锁防重复启动、后端子进程崩了也不拖累界面;数据写进用户目录,卸载软件数据还在;更新器内置 sha256 校验,国内下载优先走 COS 镜像 Agent 的技能用 SKILL.md 描述,在界面里就能增改;升级时只补缺失文件,你改过的一律不动 界面备了中、英、日、韩四种语言,AI 产出用什么语种也能在全局设置里定
技术架构拆解:一条生产线怎么塞进一台电脑
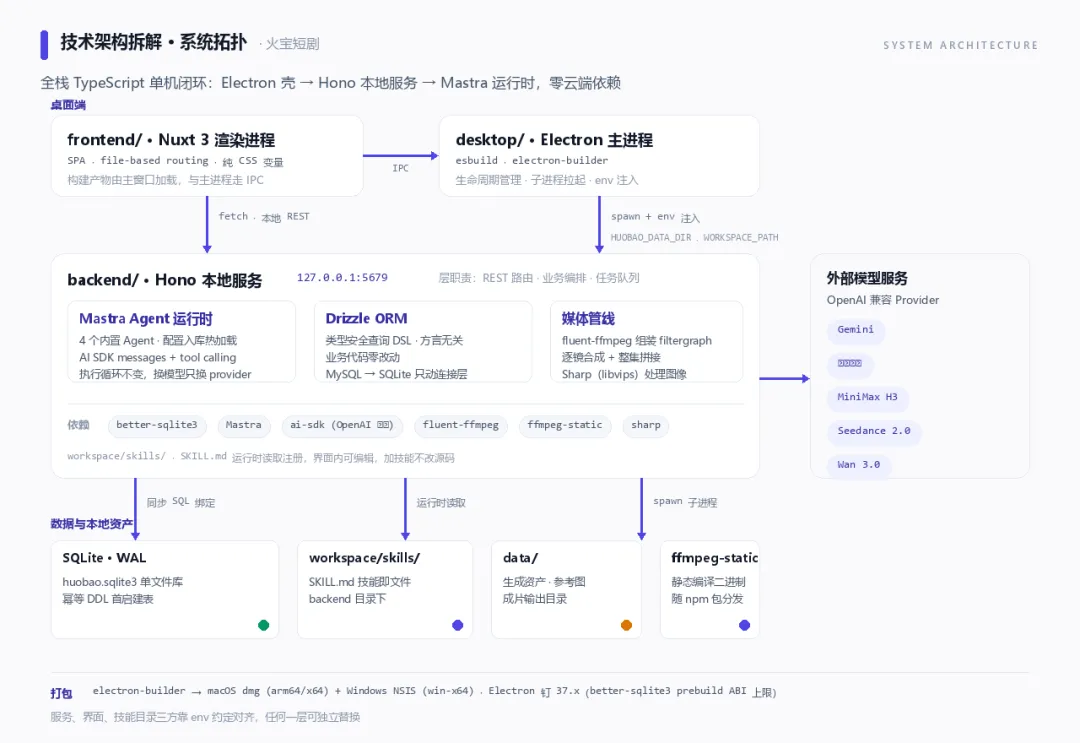
从代码组织看,火宝是一个 monorepo 里的全栈 TypeScript 工程:desktop/ 是 Electron 桌面壳,backend/ 是 Hono 本地服务,frontend/ 是 Nuxt 3 渲染层——三层都活在你的电脑上,云端一点不沾。老规矩,先上拓扑图,再顺着启动链路往下钻:
架构要点一览
进程模型:本地 Node 服务由 Electron 主进程拉起,地址固定在 127.0.0.1:5679;目录契约靠 env 传递,界面经 REST 通信 数据层:以 better-sqlite3 做进程内同步绑定,配上 SQLite WAL;单文件库,首次启动用幂等 DDL 把表建好 Agent 运行时:Mastra 加 Vercel AI SDK,靠 OpenAI 兼容协议对接各家模型;技能实体就是一个个 SKILL.md 媒体管线:用 fluent-ffmpeg 调度静态编译的 ffmpeg 二进制,图像交给 Sharp;整条媒体链路不出进程 构建打包:esbuild 与 electron-builder 组合;Electron 版本钉死在 37.x,为的是原生模块 ABI 不用本地编译
接下来按启动顺序一层层过。
进程模型与启动链路:图标点下去之后
点开图标那一刻,Electron 主进程只做两件事:其一,把 backend/ 里的 Node 服务当成子进程拉起来,让它守在本机 5679 端口;其二,往环境变量里塞目录契约——数据往 HUOBAO_DATA_DIR 放,技能工作区认 WORKSPACE_PATH。 主窗口随后载入 Nuxt 3 的构建产物(SPA 模式加文件路由);渲染层找后端办事一律走本地 HTTP REST,跟主进程打交道则走 IPC。三方靠同一套 env 约定对表,谁想被单独换掉都拦不住。
数据层:同步绑定加 WAL 的并发方案
用 SQLite 不是偷懒,是正合适——better-sqlite3 属于进程内 C++ 绑定,一次查询就是一次函数调用,省掉网络 socket 的开销,单用户桌面场景里延迟天然最低;WAL 一开,写请求落到 -wal 文件,读写两不耽误,后台渲染批量写库时界面的查询照常跑。 第一次启动会回放一遍幂等 DDL 把表建好、塞进种子数据,落到磁盘上就是 data/ 里那一个 huobao.sqlite3。业务代码从 MySQL 搬到 SQLite 一行没改,功劳在 Drizzle 的查询 DSL 把方言差异挡住了——动的只有连接层,外加一个跑一次就完事的导入脚本。
Agent 运行时:Mastra 的循环与兼容协议
那四个 Agent 全是 Mastra 的 Agent 实例,配置写进库里、跑的时候现加载;底下垫的是 Vercel AI SDK 那层 OpenAI 兼容 provider,凭 messages + tool calling 这一套协议,火山引擎、Gemini、MiniMax 通通接得住——要换模型,改改 provider 配置就行,执行循环一个字符都不用碰。 扩展的口子开在 SKILL.md 上:技能就是 backend/workspace/skills/ 下面的一份份文件,运行时读进来注册,界面里点开就能改,新增一个技能全程不碰源码。
媒体管线:fluent-ffmpeg 当包工头
合成拆两步走:先逐镜合成(图生视频的产出加音轨、字幕一起封装),再整集拼接;fluent-ffmpeg 把 filtergraph 拼好后丢给 ffmpeg 子进程去跑。二进制由 ffmpeg-static / ffprobe-static 提供,静态编译随 npm 包走、跟系统无关,想换成自己的版本就设 FFMPEG_BIN / FFPROBE_BIN。 图像这一侧交给 Sharp(libvips 的绑定)处理参考图、缩略图和封面帧的尺寸加工——整条多媒体链路在进程里自洽闭环,用户什么都不用预装。
构建与打包:ABI 约束下的钉版策略
主进程的打包交给 esbuild,渲染层由 Nuxt/Vite 出构建产物,最终经 electron-builder 产出 macOS 的 dmg(arm64 与 x64 两份)和 Windows 的 NSIS 安装器(win-x64)。 把 Electron 摁在 37.x 不是求稳,而是算过账的:better-sqlite3 在 win32 上的预编译产物最高只做到 Electron 37 那一档的 NODE_MODULE_VERSION,再往上走就得逼用户自己装编译工具链。二进制要发得完整,原生模块的 ABI 匹配就得排在框架新特性前面——这是这类桌面项目的通用取舍。
安装使用:本地把它跑起来
照着几步走,就能跑起来:
git clone https://github.com/chatfire-AI/huobao-drama.gitcd huobao-dramanpm installnpm run dev# 本地开发零配置,环境变量均有默认值源码路线:仓库拉下来之后两连击 npm install、npm run dev;所有环境变量都给好了默认值,开发环境不配置直接能跑;桌面路线(更省心):下载安装包(后端固定用 5679 端口),装好后打开「Settings → Huobao Quick Setup」,把 API Key 一贴、三组推荐配置一键落位,马上能开工。
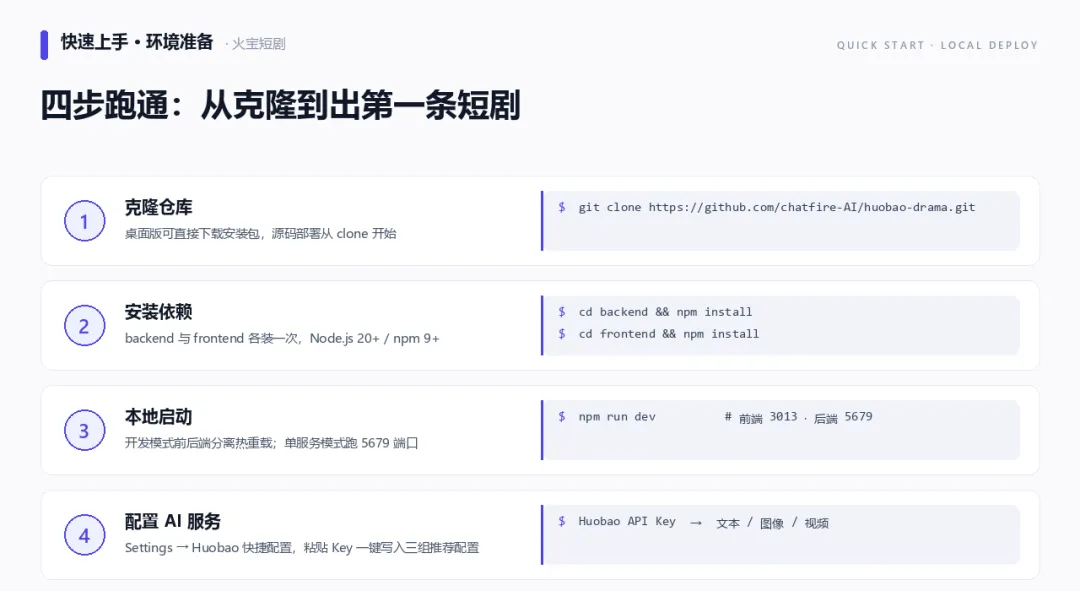
v4.0 开始项目转向 Electron 桌面形态:装完双击就用,端口自己挑、后端放在崩溃隔离的子进程里跑;存储层从 MySQL 整体换成开启 WAL 的 SQLite,FFmpeg 也一并打进包里,跟系统环境彻底解绑。另外有个细心之处:生成若因内容审核被拦(真人画面、敏感内容),它会建议你换一个模型重试,而不是甩一个报错就把流程冻住。
案例:典型用法与四类人群
典型用法:一段小说怎么走完全程
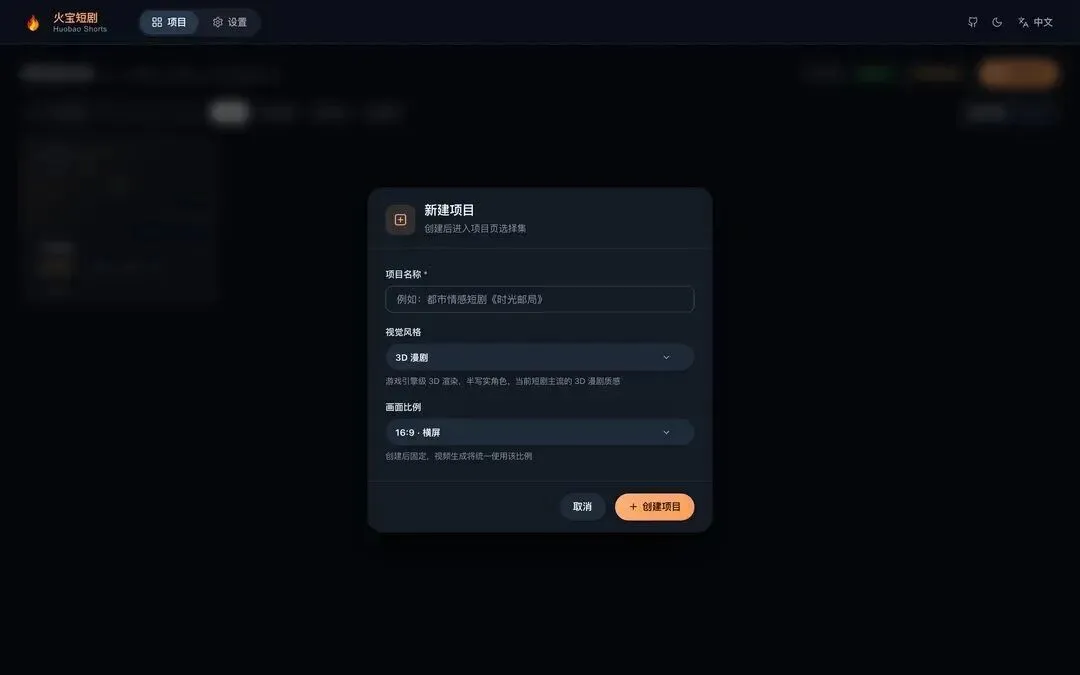
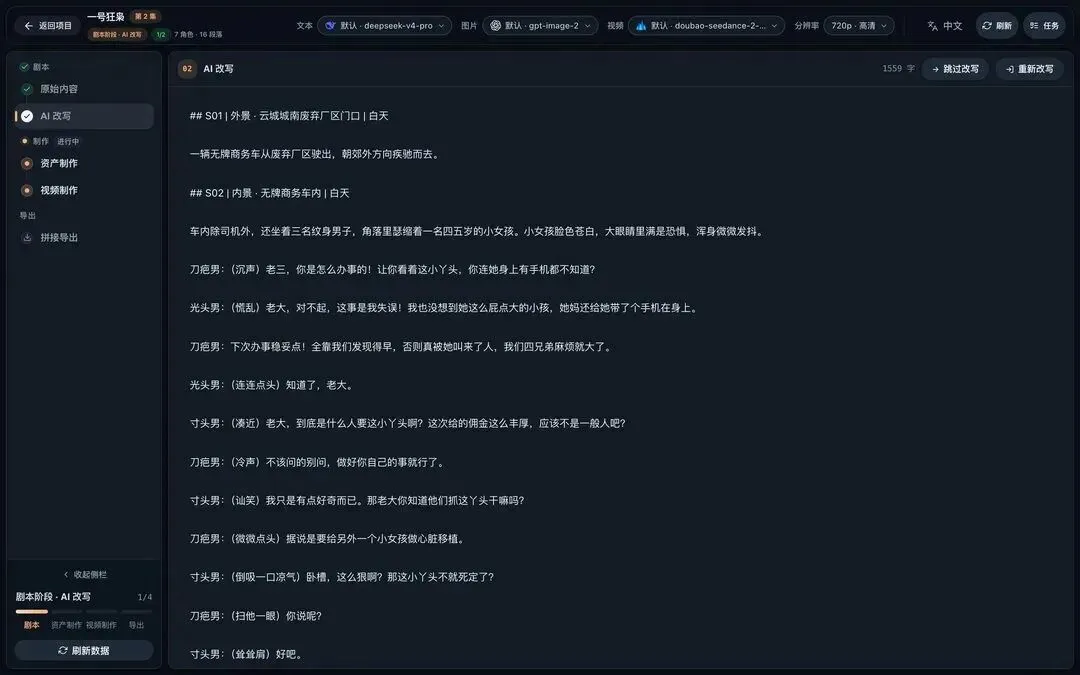
它把整套制作切成 6 个工作台,左边一条进度条始终告诉你身处第几步;分集列表想回哪一集就回哪一集。下面走一遍:
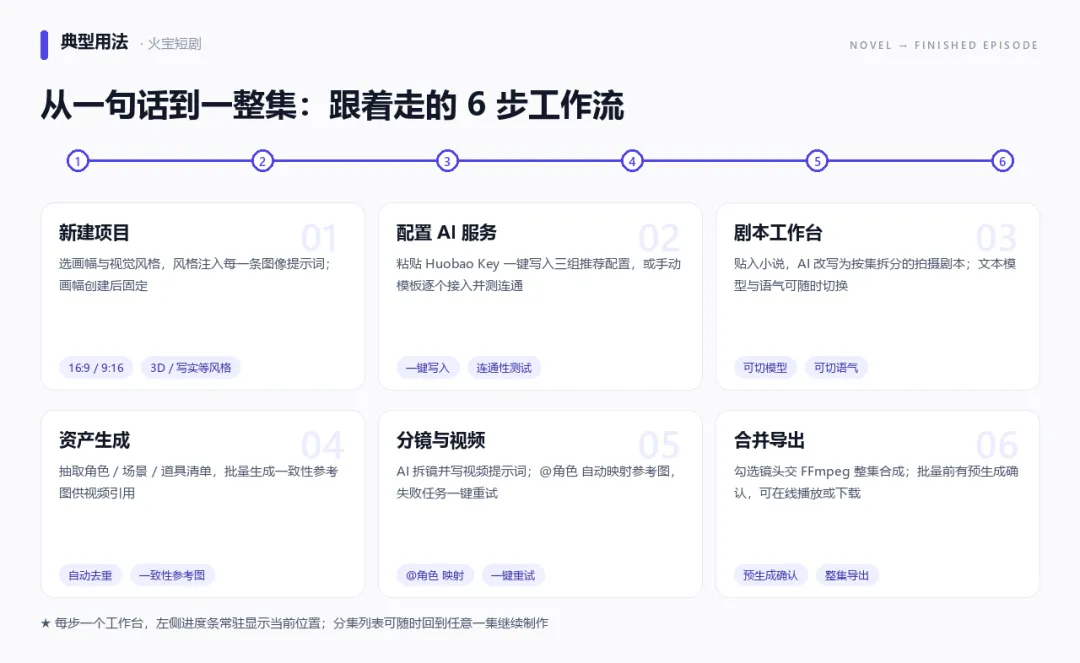
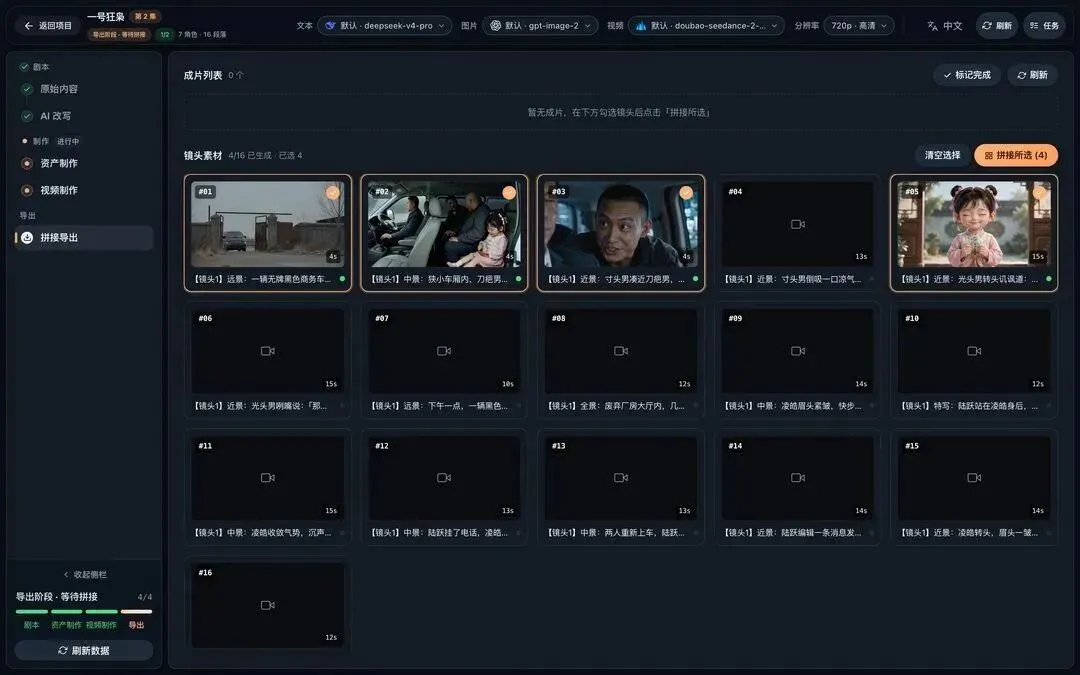
有几处细节值得留意:建项目时挑的画面比例(16:9 或 9:16)与视觉风格,会一路注进后续每条图像提示词;批量生成前那道「预生成确认」把镜头数、总时长、用哪个模型、什么分辨率并排列出,一次看全;@角色 会自动带上参考图,省去手动传图;拼整集之前先确认每个视频文件都在,跑挂的任务一键补——对靠日更吃饭的账号来说,这套防出错机制比任何炫技功能都实在。
适用场景:四类人,各取所需
个人创作者(想低成本试试 AI 短剧这摊水):装 App、填 Key、跑出第一条,数据库和命令行一概不用碰;先用一集探探「从小说到成片」这条路顺不顺,再决定投入多深; 内容团队(要快速量产短剧样片):一条流程反复喂不同的本子,批量生成、预生成确认、一键重试三件套把出错率摁住,样片到手就能筛剧本; 非技术背景玩家:数据库和 FFmpeg 都在包里,环境变量个个带默认值,需要动手填的只有 API Key 一项; 比价党:顶栏在 Seedance / Wan 3.0 / MiniMax 之间随便切,同一份分镜挨个模型跑一遍,效果和账单放一起比。
结尾总结:什么情况值得上它
火宝短剧对得上这几类需求:
还没攒出自己的 AI 短剧工作流、想先低成本把全流程趟一遍的创作者; 需要快速堆出一批样片、用来判断剧本值不值得拍的内容团队; 不会写代码的普通用户:桌面 App 连同零配置的数据库、FFmpeg 一起给你,装完就用; 懒得自己对接模型、接受火宝 API 默认配置的用户。
1.6 万多个 star,攒的全是「开箱即用」这份口碑——AI 短剧如果你只是听过、还没跑过,那火宝大概是上手门槛最低的入口。
如果这篇对你有用
如果这篇帮你绕开了几个坑:点个「在看」,让还在门外张望的朋友少绕点路;顺手收藏,装 App、填 Key 的步骤随时翻得到;也欢迎关注,这个系列会接着把值得琢磨的开源 AI 视频项目逐个拆开,下一期拆什么、何时发,关注之后不会错过。你已经用它做过片子了吗?评论区聊聊。
数据核对声明:文中 star / fork / 版本 / 发版日期等数据取自 2026-10-19 的 GitHub API 与项目 Releases 页面(16351★ / 3035 fork / 最新版 v4.0.8,2026-10-05 发布)。授权方面,项目用的是 CC BY-NC-SA 4.0(禁止商用);桌面安装包和 Docker 镜像都请从官方 GitHub Releases 下载。它属于社区开源作品,动手前请自行评估依赖安全与合规风险;若要用到声音克隆、视频复刻一类能力,素材授权与平台规则务必先确认清楚。

